Trazabilidad del linaje
Qué lote entró, en qué momento y desde qué fuente. Si el registro no permite responder esas tres preguntas, el lote no pasa la revisión.
En Centinela Algorítmico no hablamos de certificaciones. Hablamos de criterios verificables que un equipo técnico puede aplicar sobre su propio pipeline antes de reentrenar un modelo de scoring. La pregunta de fondo es simple: si mañana aparece una desviación en un segmento, ¿podemos reconstruir qué lote entró, cuándo y desde dónde? Si la respuesta es no, cualquier investigación empieza desde cero.
Un lote se considera trazable cuando su registro de procedencia permite reconstruir el origen, las transformaciones aplicadas y el momento exacto de ingreso al pipeline. Sin ese registro, comparar dos versiones del modelo es adivinar. El criterio no exige una herramienta específica, sino que la cadena sea reconstruible hacia atrás sin huecos.
La partición de validación debe respetar el orden cronológico y no mezclar franjas. Cuando el fraude o la manipulación se inyecta en una ventana concreta, una división aleatoria reparte la contaminación entre entrenamiento y prueba, y el rendimiento reportado deja de sostenerse en operación real.
Las métricas agregadas pueden mantenerse estables mientras un subgrupo se degrada. El criterio es comparar siempre con la misma referencia y sobre ventanas equivalentes, no contra promedios históricos que ocultan el desplazamiento de la frontera de decisión en un segmento puntual.
Cuando una señal de reconstrucción o de embeddings se aparta del rango esperado, el criterio es registrar la desviación antes de tocar umbrales. Ajustar primero borra la evidencia y convierte una señal temprana en un falso positivo sin historial que lo explique.
En esta página reunimos los criterios internos con los que evaluamos un lote antes de que entre al entrenamiento. No son certificaciones externas ni avales de terceros: son reglas de trabajo que aplicamos para decidir si un conjunto de datos biométricos o transaccionales es confiable. Un lote se considera trazable cuando su registro de procedencia permite reconstruir qué lote ingresó, cuándo y desde dónde. Sin esa cadena, cualquier revisión posterior empieza a ciegas.
La consistencia temporal exige que la partición de validación respete el orden cronológico y no mezcle franjas. Cuando una franja se contamina de forma deliberada, una división aleatoria reparte el daño entre entrenamiento y prueba, y el rendimiento reportado deja de sostenerse en operación real. Por eso comparamos segmentos con la misma referencia y sobre ventanas equivalentes: si el tramo reciente cae y el promedio no se mueve, la señal está ahí aunque las métricas agregadas la escondan.
Cuando una señal de reconstrucción o de embeddings se aparta del rango esperado, el criterio es documentar la desviación antes de tocar umbrales. Ajustar primero y anotar después borra la evidencia de lo que ocurrió. Estos estándares describen qué se observa y cómo se registra; no prometen resultados ni garantizan que un lote esté libre de manipulación.
Qué lote entró, en qué momento y desde qué fuente. Si el registro no permite responder esas tres preguntas, el lote no pasa la revisión.
La partición de validación respeta el orden cronológico. Mezclar franjas oculta la contaminación inyectada en un periodo concreto.
Misma referencia y ventanas equivalentes. Una caída localizada con promedio estable es una señal, no un ruido que convenga ignorar.
Ante un error de reconstrucción o un desplazamiento en los embeddings, primero se documenta el apartamiento y después se revisa el umbral.
Las escenas que siguen no documentan auditorías reales ni equipos del proyecto. Son referencias gráficas para fijar la mirada: qué se observa cuando un conjunto de entrenamiento deja de comportarse como se esperaba y qué señales conviene registrar antes de tocar cualquier umbral.
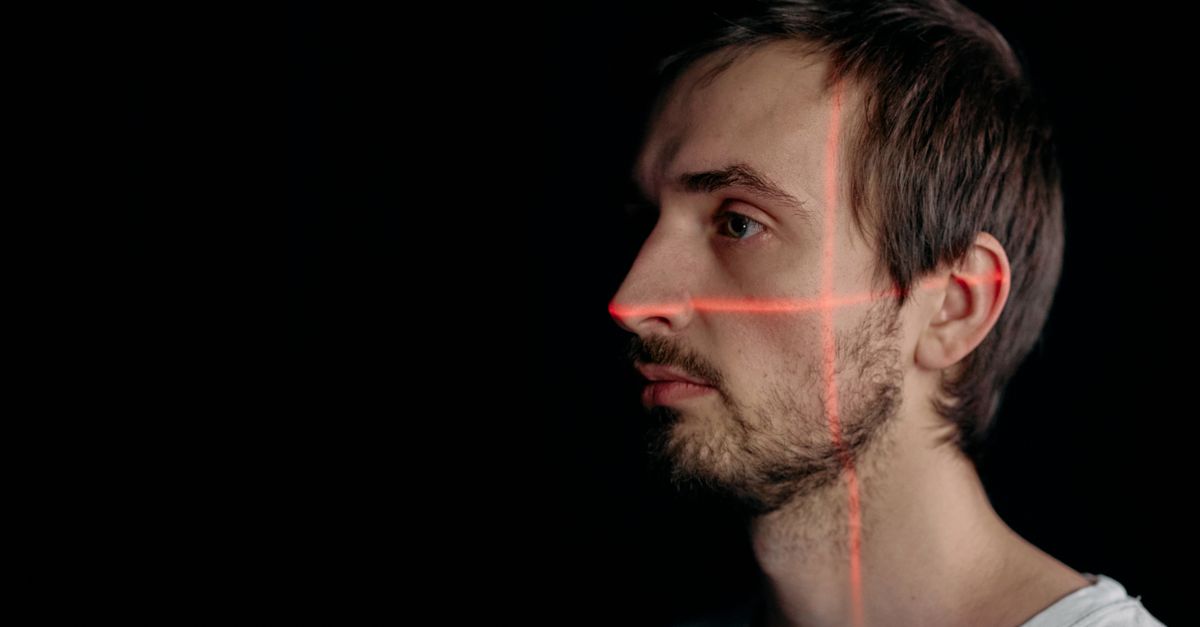 Muestras biométricas
Cuando una captura biométrica se usa como referencia, lo que importa no es la cara sino la retícula: si los puntos de referencia se desplazan de forma sistemática entre lotes, la distribución dejó de ser la misma.
Una red siamesa vive de estas distancias. Si los nodos que deberían estar separados empiezan a agruparse, hay que revisar qué pares entraron al entrenamiento y con qué etiqueta.
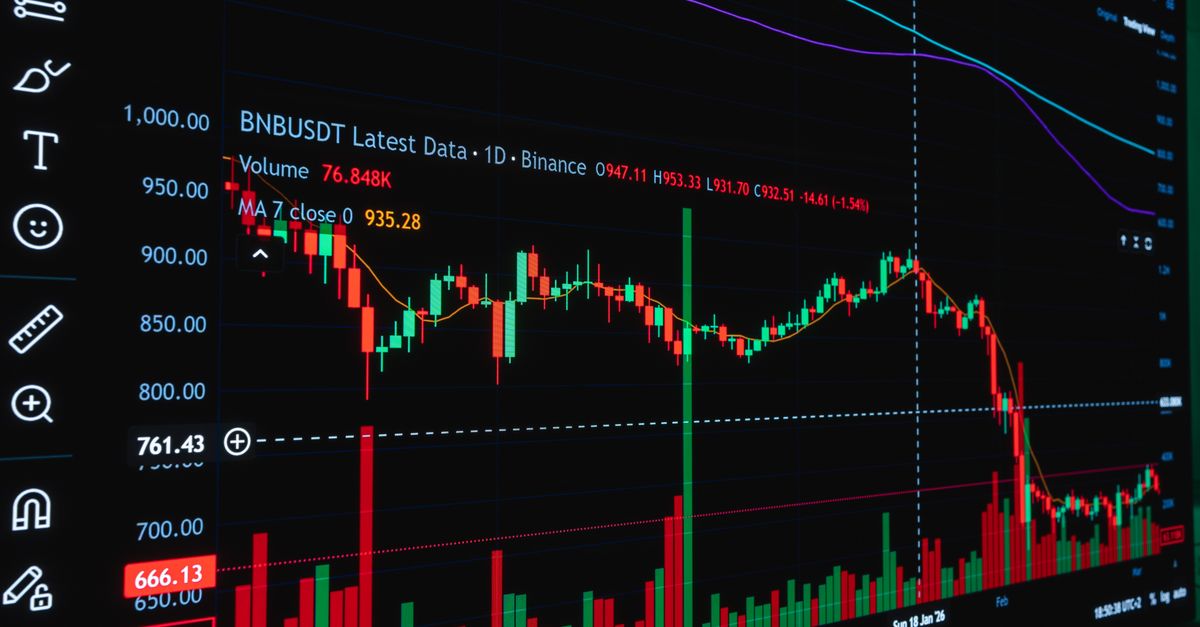 Consistencia temporal
Un salto aislado en una franja temporal concreta suele ser la primera pista de contaminación inyectada. La partición de validación debe respetar ese orden para no diluir el efecto.
 Nodos federados
En un esquema federado cada nodo aporta sin compartir sus datos. La vista ayuda a recordar que una sola contribución sesgada, sostenida en el tiempo, alcanza para inclinar el modelo agregado.
 Linaje de datos
El registro de procedencia permite reconstruir qué lote ingresó, cuándo y desde dónde. Sin ese rastro, cualquier desviación se investiga desde cero y termina en sospechas sin evidencia.
Estas imágenes son ilustrativas. No representan instalaciones, equipos ni resultados del proyecto; solo acompañan los criterios de observación descritos en esta página.
Usamos cookies para recordar tu elección y mejorar tu experiencia de navegación. Podés aceptarlas o rechazarlas; tu decisión se guarda en este navegador.
Más información en nuestra política de privacidad.